Prompt Injection Detector Benchmark
Исследование того, насколько надёжны детекторы prompt injection на самом деле. Пять видов детекторов обучены на двух открытых датасетах и проверены на данных друг друга.
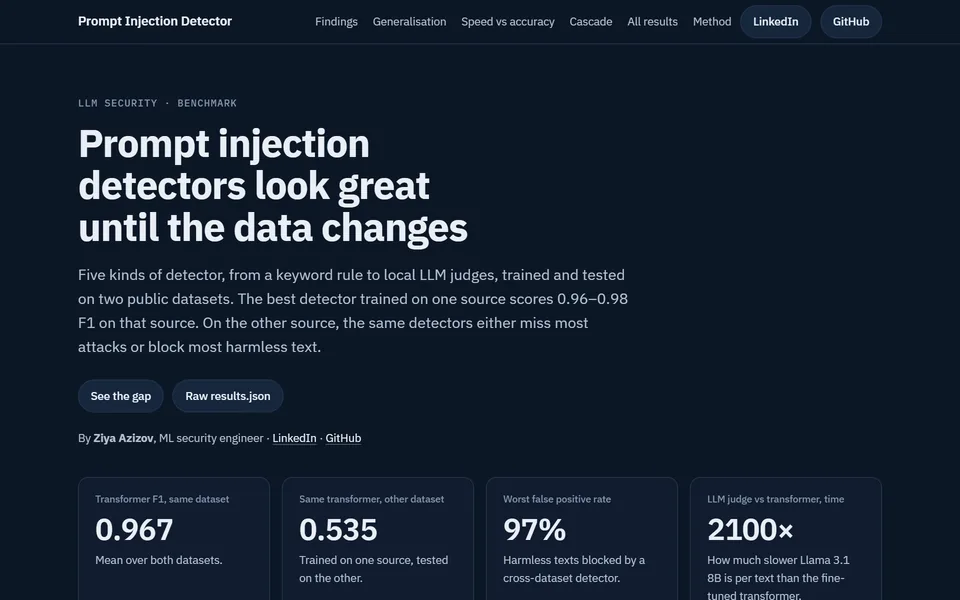
Многие компании защищают своих AI-чат-ботов детекторами, которые пытаются распознать вредоносный текст. Это исследование проверяет, насколько надёжны такие детекторы, когда данные меняются.
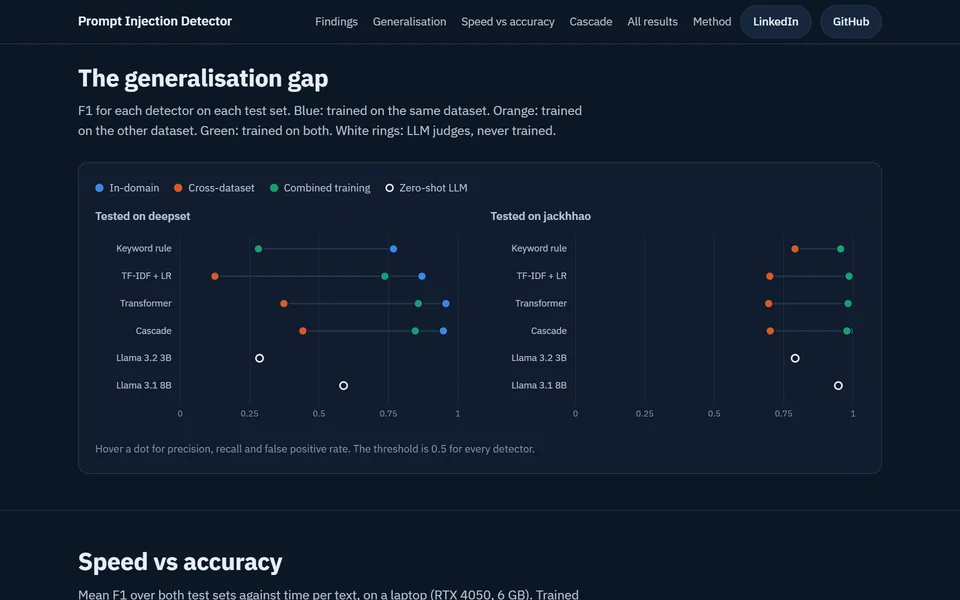
Проверено пять видов детекторов: правило по ключевым словам, TF-IDF + логистическая регрессия, дообученный многоязычный трансформер DistilBERT, каскад и локальные модели Llama 3.2 3B и Llama 3.1 8B в роли LLM-судей. Все обучены на двух открытых датасетах (deepset и jackhhao) и проверены на данных друг друга.
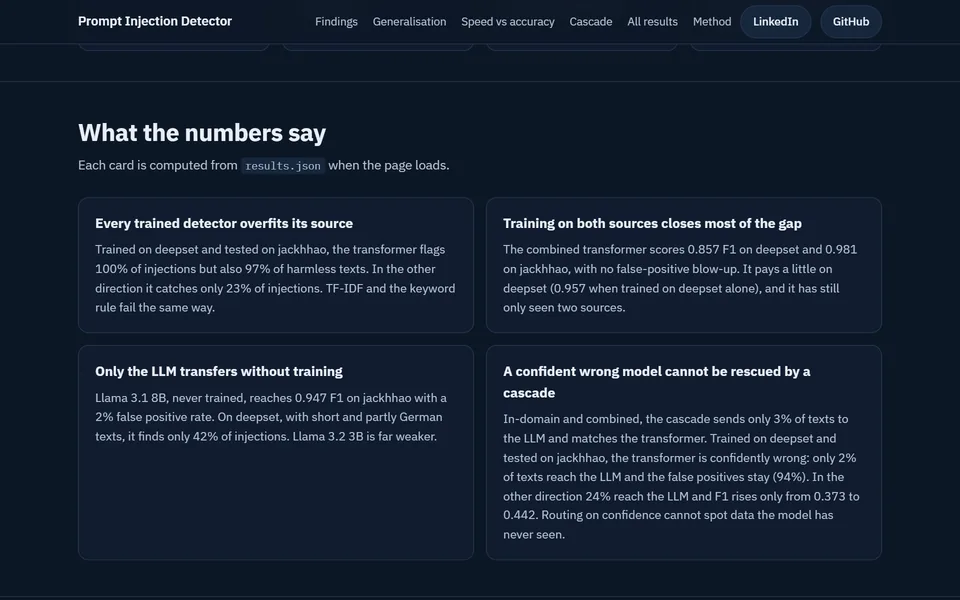
Результат: детектор, который получает 0.96–0.98 F1 на своём датасете, на другом либо пропускает большинство атак, либо блокирует до 97% безобидного текста. На сайте все результаты показаны в интерактивных графиках, включая график скорости и точности, и в полной таблице.
- Обучение на обоих датасетах закрывает большую часть разрыва.
- Llama 3.1 8B достигает 0.947 F1 на jackhhao без обучения, но в 2 100 раз медленнее трансформера.
- Каскад не спасает модель, которая уверенно ошибается.