Prompt Injection Detector Benchmark
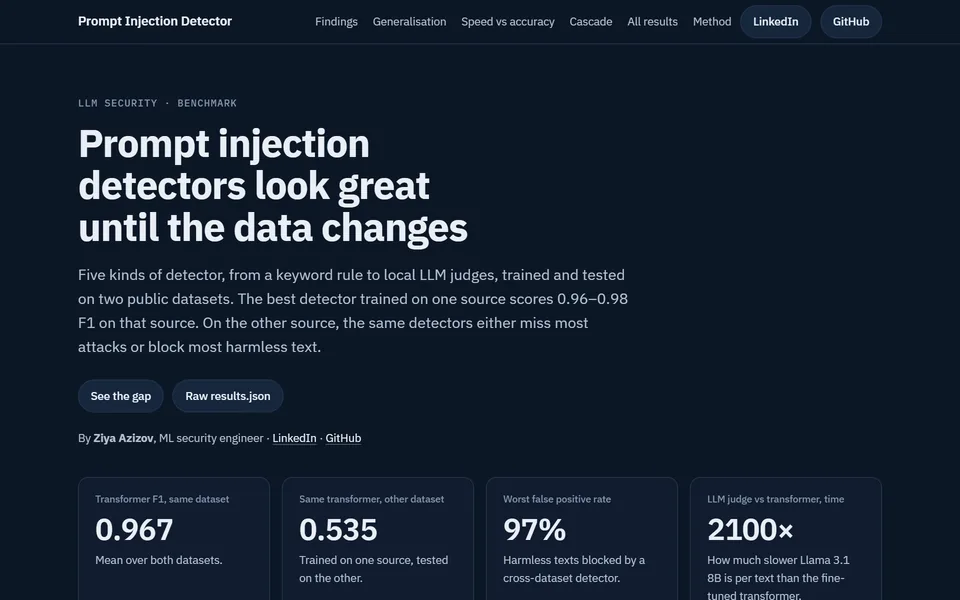
Prompt injection detektorlarının həqiqətən nə qədər etibarlı olduğunu ölçən tədqiqat. Beş növ detektor iki açıq datasetdə öyrədilib və bir-birinin datasetində yoxlanılıb.
Bir çox şirkət AI chatbotunu qorumaq üçün "zərərli mətni tanıyan" detektorlardan istifadə edir. Bu tədqiqat həmin detektorların data dəyişəndə nə qədər etibarlı qaldığını yoxlayır.
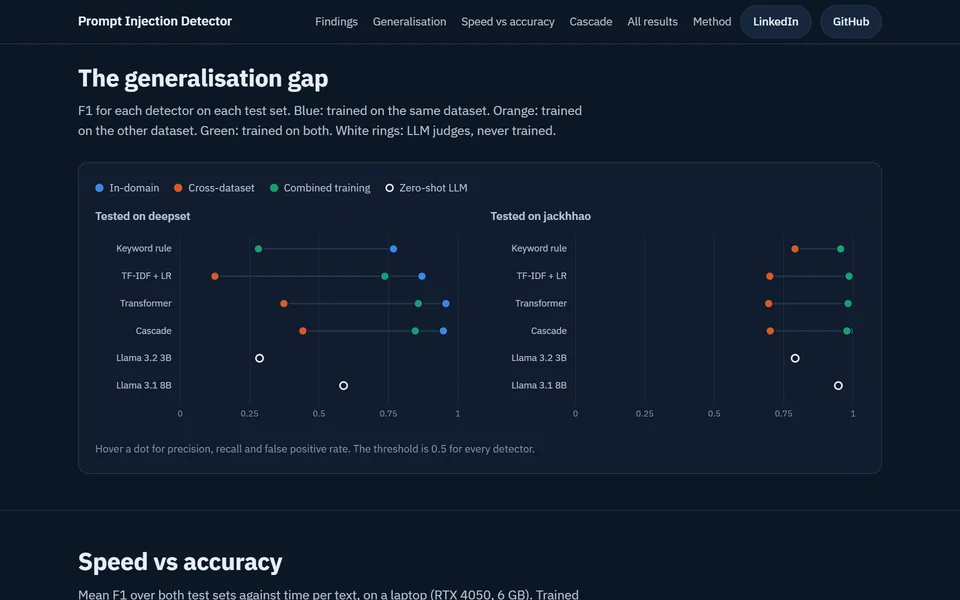
Beş növ detektor sınanıb: açar söz qaydası, TF-IDF + logistik reqressiya, fine-tune olunmuş çoxdilli DistilBERT transformer, kaskad sistem və lokal Llama 3.2 3B və Llama 3.1 8B modelləri (LLM hakim). Hamısı iki açıq datasetdə (deepset və jackhhao) öyrədilib və bir-birinin datasetində test olunub.
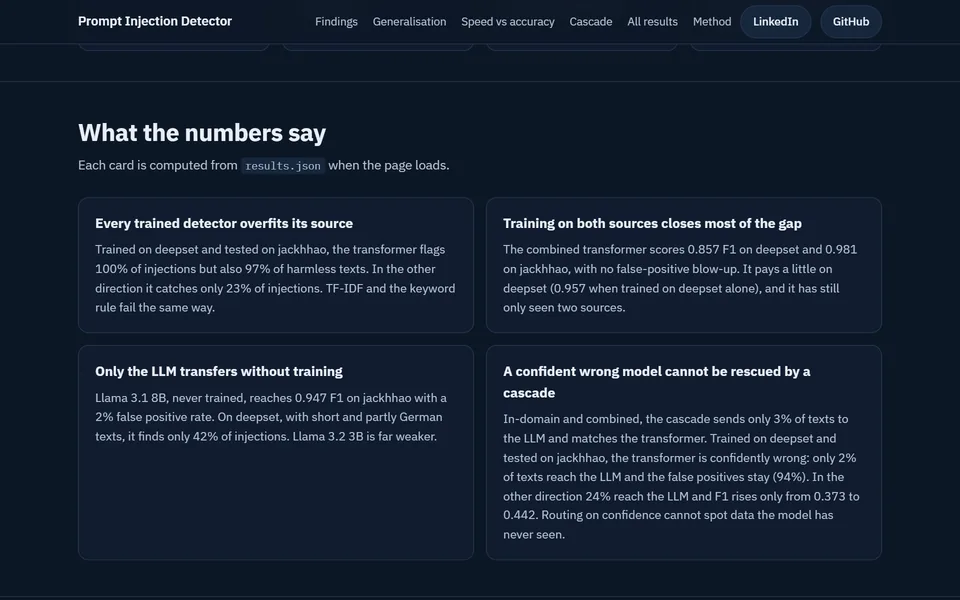
Nəticə: eyni datasetdə 0.96–0.98 F1 göstərən detektor digər datasetdə ya hücumların çoxunu buraxır, ya da zərərsiz mətnlərin 97%-ni bloklayır. Sayt bütün nəticələri interaktiv qrafiklər, sürət-dəqiqlik müqayisəsi və tam cədvəllə göstərir.
- İki datasetdə birgə öyrətmək boşluğun çoxunu bağlayır.
- Llama 3.1 8B heç öyrədilmədən jackhhao-da 0.947 F1 alır, amma transformerdən 2100 dəfə yavaşdır.
- Kaskad özündən əmin, amma səhv olan modeli xilas edə bilmir.